Como extrair texto de foto, print ou PDF escaneado (OCR) e quando usar a IA
OCR é a tecnologia que lê o texto de uma imagem. Este guia mostra como copiar o texto de uma foto de documento ou de um PDF escaneado, o que melhora a precisão e em que casos vale ativar o modo de IA opcional (que envia a imagem a um serviço externo).
Guia escrito por Marcelo Amantino · atualizado em 5 de outubro de 2026 · quem somos
Onde seus dados são processados
Funciona localmente por padrão. Só se você ativar o recurso de IA, a imagem ou página do PDF em análise é enviado a Groq (modelo de visão).
O modo padrão roda inteiro no seu navegador (Tesseract.js): a imagem não sai do seu aparelho. Existe um modo opcional de IA, indicado para manuscritos e fotos difíceis; ele só é usado se você marcar a opção, e nesse caso a imagem é enviada ao Groq para ser lida. A página avisa isso antes do uso. Se o documento for sensível, mantenha o modo local.
Veja a lista completa na página de Privacidade & LGPD.
Situações reais de uso
Copiar o texto de uma nota fiscal ou comprovante fotografado
Situação: Você tem uma foto de um comprovante e precisa dos dados em texto, sem digitar.
- Envie a foto, de preferência reta, bem iluminada e sem reflexo.
- Escolha o idioma do texto (português, por exemplo) e mantenha o modo local.
- Aguarde o reconhecimento e revise o texto, principalmente números, datas e valores.
- Copie o texto ou exporte em TXT, Word ou Excel.
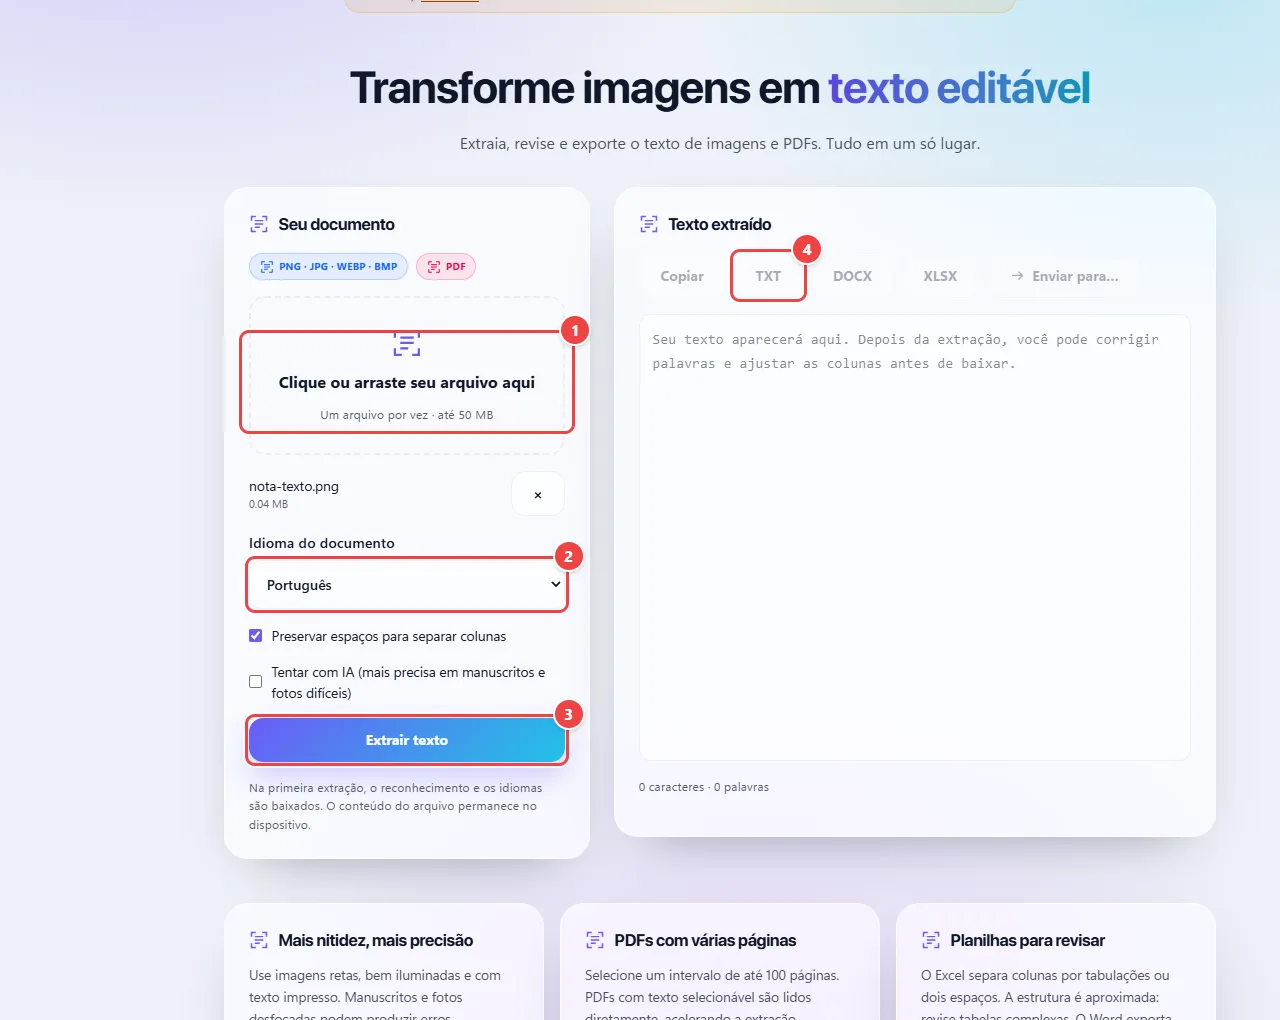
- Ponto 1: Envie a imagem ou o PDF: clique na área ou arraste o arquivo (PNG, JPG, WEBP, BMP ou PDF de até 50 MB).
- Ponto 2: Escolha o idioma do texto: ele muda bastante o resultado, principalmente com acentos.
- Ponto 3: Extrair texto: no modo local, o reconhecimento roda no seu navegador.
- Ponto 4: Depois de revisar o texto, copie ou exporte em TXT, DOCX ou XLSX.
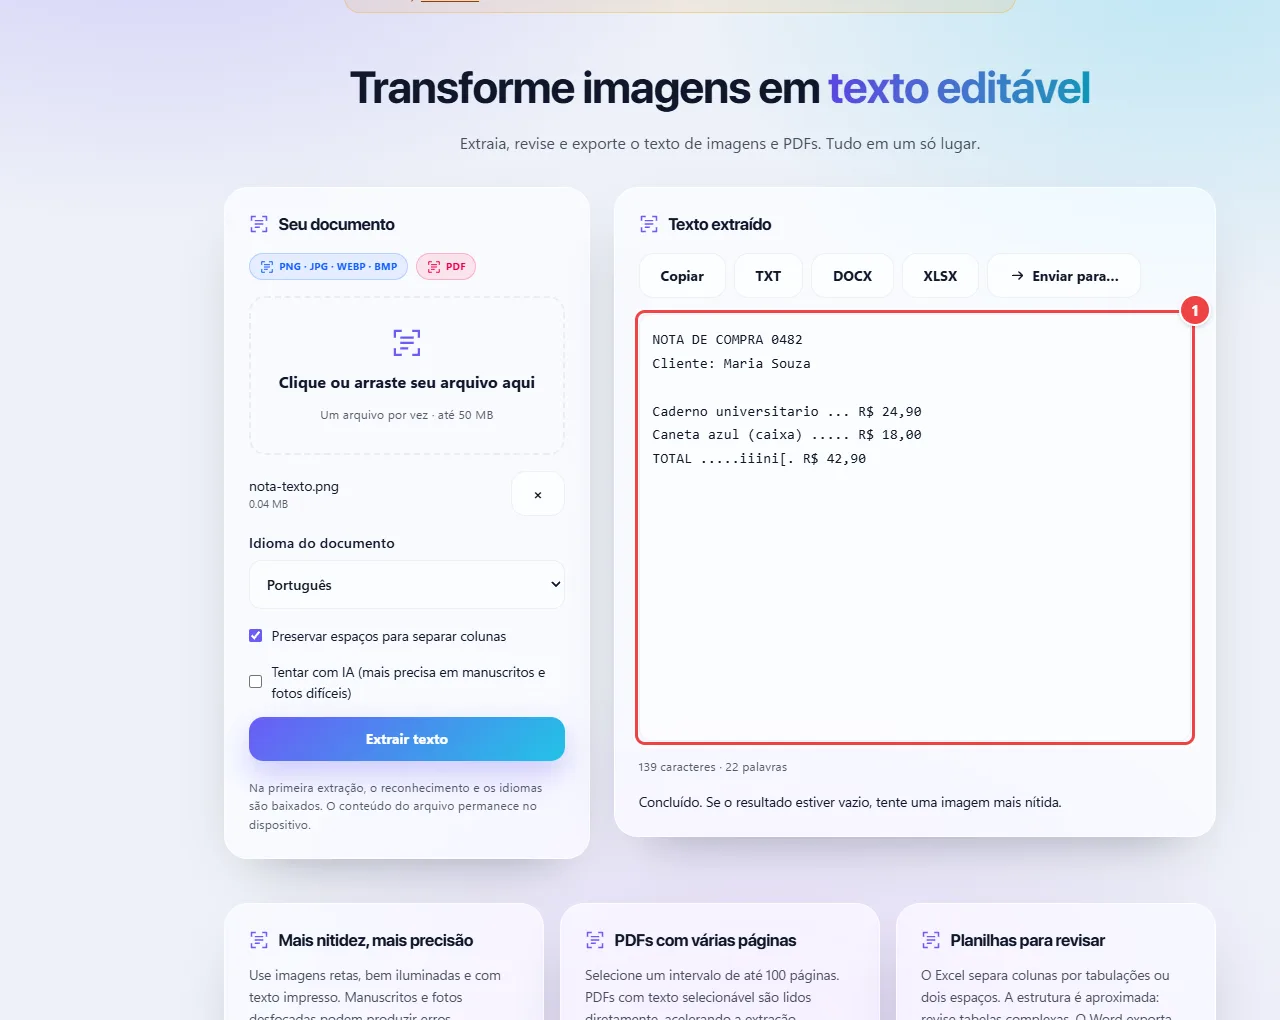
- O texto reconhecido aparece aqui e pode ser corrigido na própria caixa. Revise números e nomes próprios, que são os trechos em que o OCR mais erra.
Resultado: O texto da imagem pronto para copiar, com possíveis pequenos erros que você corrige na revisão.
Tornar um PDF escaneado pesquisável e copiável
Situação: Um PDF que veio do scanner é só uma imagem: você não consegue selecionar nem buscar o texto.
- Envie o PDF escaneado.
- Escolha o idioma correto, pois ele melhora a leitura de acentos e palavras.
- Execute o reconhecimento e revise o resultado.
- Exporte o texto no formato que preferir.
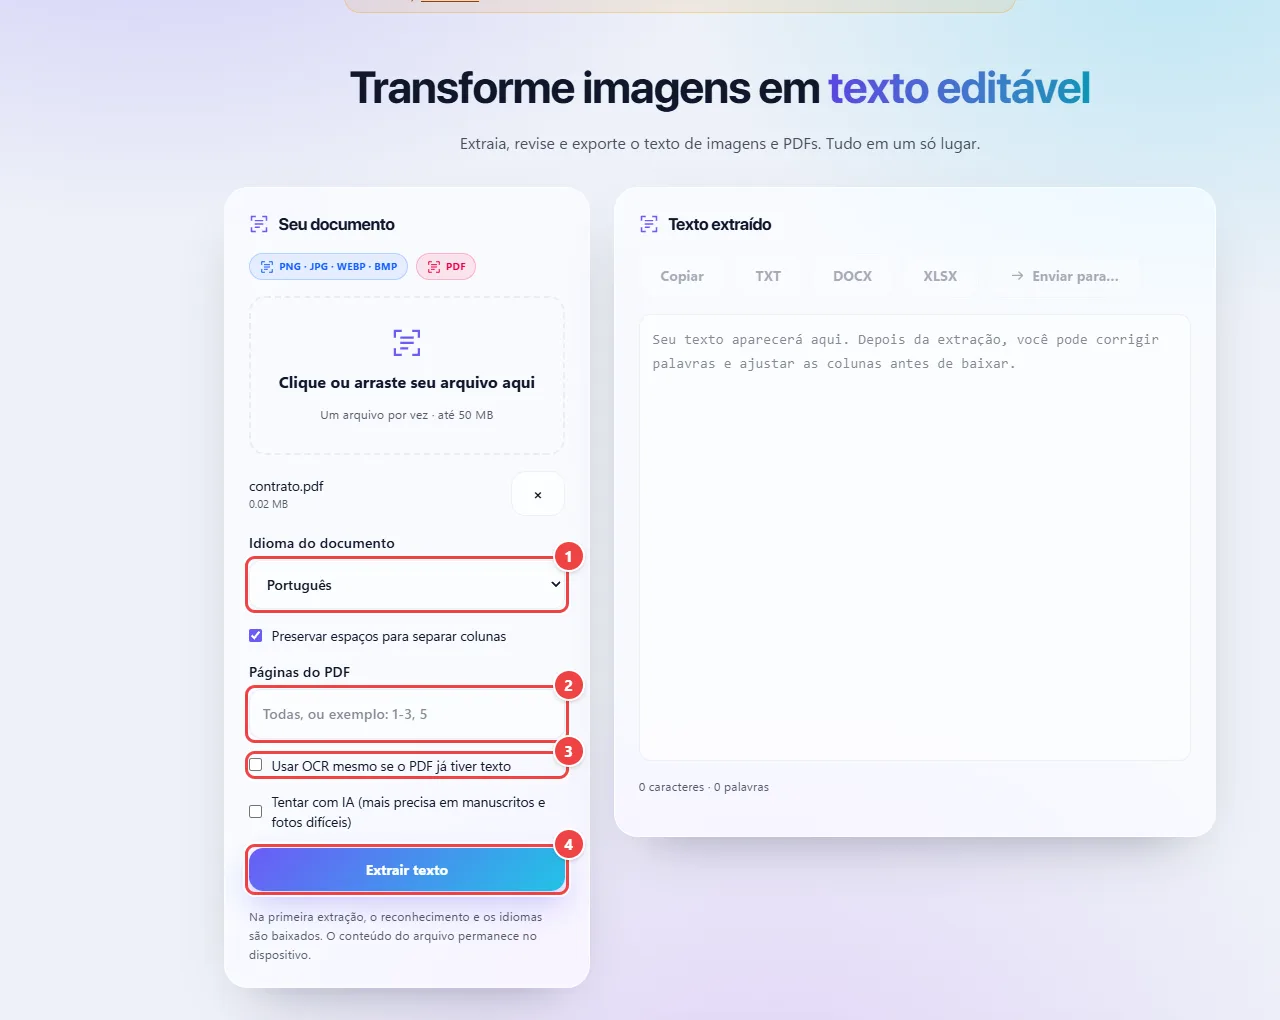
- Ponto 1: Escolha o idioma: ele melhora a leitura de acentos e palavras.
- Ponto 2: Para um PDF grande, informe só as páginas que importam (por exemplo, 1-3, 5).
- Ponto 3: Marque se o PDF já tem uma camada de texto ruim e você quer reler as páginas como imagem.
- Ponto 4: Extrair texto: no modo local, o reconhecimento roda no seu navegador.
Resultado: O conteúdo em texto, que você pode buscar, copiar e editar.
Tentar ler um manuscrito com a IA opcional
Situação: O OCR local erra muito em letra de mão. Você aceita enviar a imagem ao serviço de IA para tentar um resultado melhor.
- Envie a imagem e marque a opção de tentar com IA, ciente de que a imagem será enviada ao serviço indicado na página.
- Aguarde o resultado.
- Revise com atenção: mesmo com IA, manuscritos podem ter trechos incorretos.
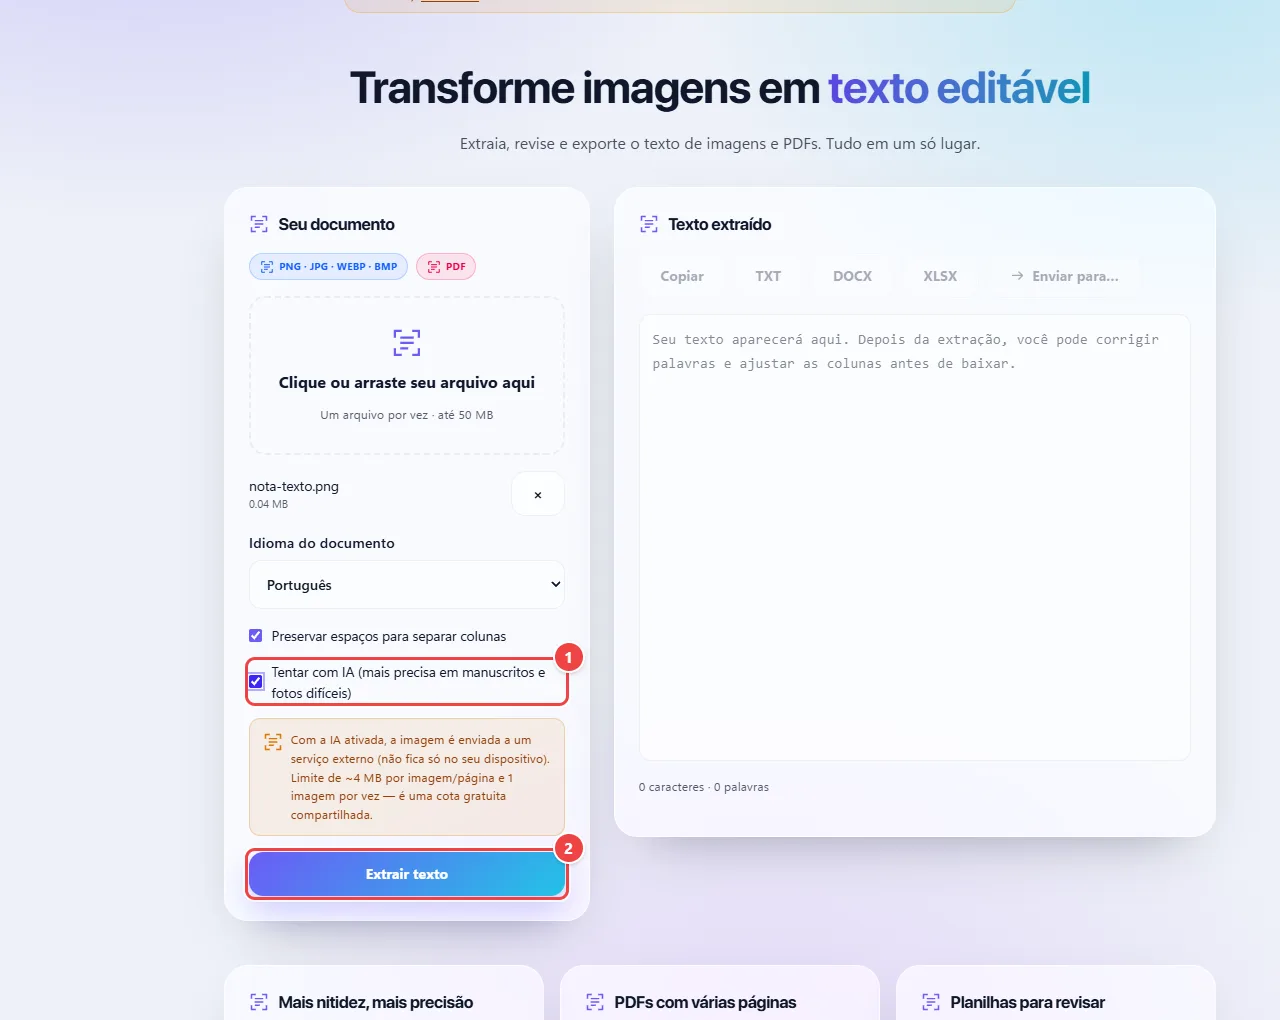
- Ponto 1: Marque “Tentar com IA” só se aceitar enviar a imagem a um serviço externo. Sem a marca, tudo continua no seu navegador.
- Ponto 2: Extrair texto usa a IA nesta imagem. Revise o resultado: manuscritos ainda podem ter trechos incorretos.
Resultado: Um texto mais próximo do original que o modo local costuma entregar em letra de mão.
Dicas para um resultado melhor
- Fotografe de cima, com o documento reto e a câmera paralela à folha; inclinação reduz a precisão.
- Boa luz vale mais que resolução alta: evite sombras e reflexos.
- Recorte a imagem para deixar só a área com texto.
- Revise sempre números, CPF, valores e datas; um dígito trocado muda o sentido.
Limites e quando esta não é a melhor opção
- Fotos tremidas, escuras ou com baixa resolução reduzem muito a precisão.
- Tabelas e layouts em várias colunas podem sair com a ordem do texto misturada.
- Manuscritos funcionam melhor com o modo de IA, que envia a imagem a um serviço externo. Não use com documentos que não podem sair do seu aparelho.
Perguntas frequentes
- Meu documento é enviado a algum servidor?
- No modo local, não. Só se você marcar a opção de IA a imagem é enviada, e a página avisa isso antes.
- Por que o texto saiu com erros?
- A qualidade da imagem pesa mais que qualquer outro fator. Melhore a iluminação, fotografe reto, aumente a resolução ou recorte a área do texto.
- Que formatos posso exportar?
- TXT, Word e Excel.
- Funciona com idiomas além do português?
- Sim: escolha o idioma do texto antes de processar para melhorar a leitura.